Typowane decyzje, kontrakt API i ekonomika tokenów
Decyzyjny model AI odpowiada (z założenia) na węższe pytania niż generatywny LLM: dla dostarczonego na wejściu “stanu” i jawnie opisanych wariantów wyboru, wyznacza decyzję w postaci ściśle typowanego wyniku. To komponent przydatny wtedy, gdy aplikacja potrzebuje routingu, klasyfikacji, oceny albo bramki, a nie uzasadnienia decyzji w języku naturalnym (co zapewne irytuje Was w LLM tak samo często, jak mnie). Konsekwencja architektoniczna jest dwojaka: kontrakt wyniku jest łatwiejszy do walidacji, a koszt jest w większości przypadków znacznie niższy. Oszczędność nie wynika jednak z „darmowego AI”, lecz z mniejszego zadania, krótszego kontekstu i ograniczenia generowania tekstu – do tego szkolone są modele tego typu i jednym z ich głównych założeń jest oszczędność (zarówno po stronie vendora, jak i klienta).
Poniżej rozkładam na części konkretny przykład z trzema decyzjami dla jednej wiadomości o dwóch nieudanych płatnościach (to generyczny przykład z Microsoft Foundry, który możecie przetestować sami, do czego oczywiście zachęcam). Staram się oddzielić, a raczej odróżńić zachowanie opisane przez Microsoft w dokumentacji od interpretacji odpowiedzi, hipotez architektonicznych i przyjętych założeń kosztowych, więc znajdziecie tu nieco więcej niż w dokumentacji modelu. Model Microsoft-Decision-1 jest obecnie oznaczony w katalogu jako Preview, więc nie powinniśmy traktować implementacji w Foundry jako finalnej (kto z Was korzysta z Foundry, ten wie…)
Decyzja jako typowany wynik
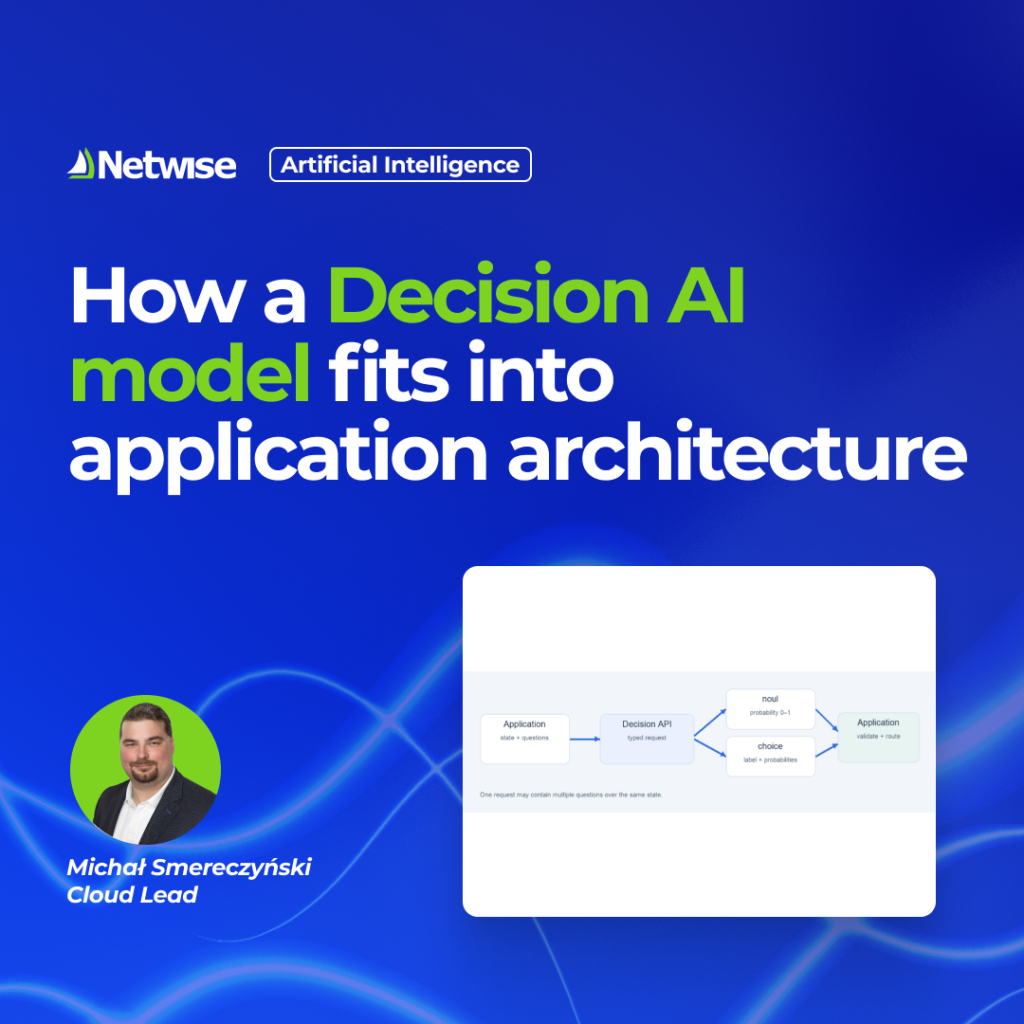
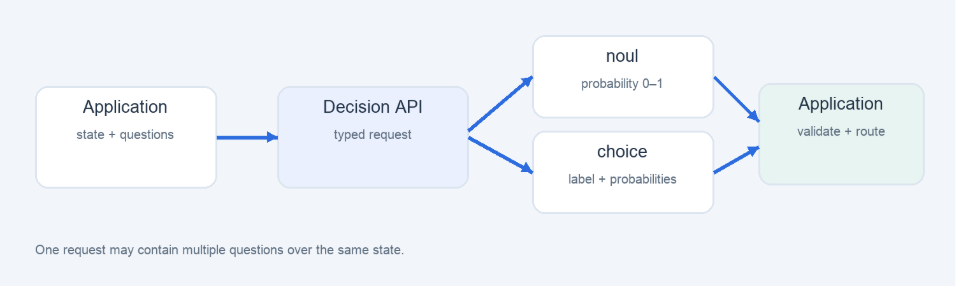
Typowy workflow z użyciem generatywnego AI wygląda tak, że aplikacja podaje modelowi instrukcje, prosi o JSON, odbiera tekst, parsuje go i sprawdza, czy nie brakuje pól lub czy wartość mieści się w dozwolonym zbiorze. Ograniczony format odpowiedzi może poprawić niezawodność, ale nadal jest to generowanie tokenów. Model typu decyzyjnego przyjmuje stan (state) oraz jedno lub więcej pytań o jawnych typach (statycznie typowanych, mówiąc językiem dev, ale chodzi tu bardziej o deklarację tego typu). Zwraca wyniki pod tymi samymi nazwami (kluczami), zamiast produkować swobodną wypowiedź. Dokumentacja opisuje trzy definicje typów: noul dla pytania binarnego, choice dla zamkniętego wyboru i score dla uporządkowanej skali.
noul oznacza „yes/no” jako prawdopodobieństwo dla warunku w zakresie od 0 do 1. choice zwraca jedną etykietę oraz prawdopodobieństwa wariantów. score zwraca prawdopodobieństwa poziomów skali i liczbę obliczaną jako ich średnia ważona indeksami poziomów. Dla score indeksy zaczynają się od zera; trzy poziomy tworzą zakres indeksów 0–2.
Jedno żądanie może zawierać wiele pytań do tego samego state. Dzięki temu model ocenia w poniższym przykładzie pilność, zespół i priorytet w obrębie jednego wejścia, a aplikacja nie musi wykonywać trzech niezależnych wywołań. Dokumentacja wskazuje łączenie pytań jako sposób ograniczenia liczby requestów i (przede wszystkim – przypis autora) utrzymania wspólnego kontekstu. Nie oznacza to gwarancji identycznej jakości lub niezależności wyników: każde pytanie nadal wymaga osobnej walidacji na danych produkcyjnych – ale to już jest temat na inny wpis.
Przykład: dwie nieudane płatności
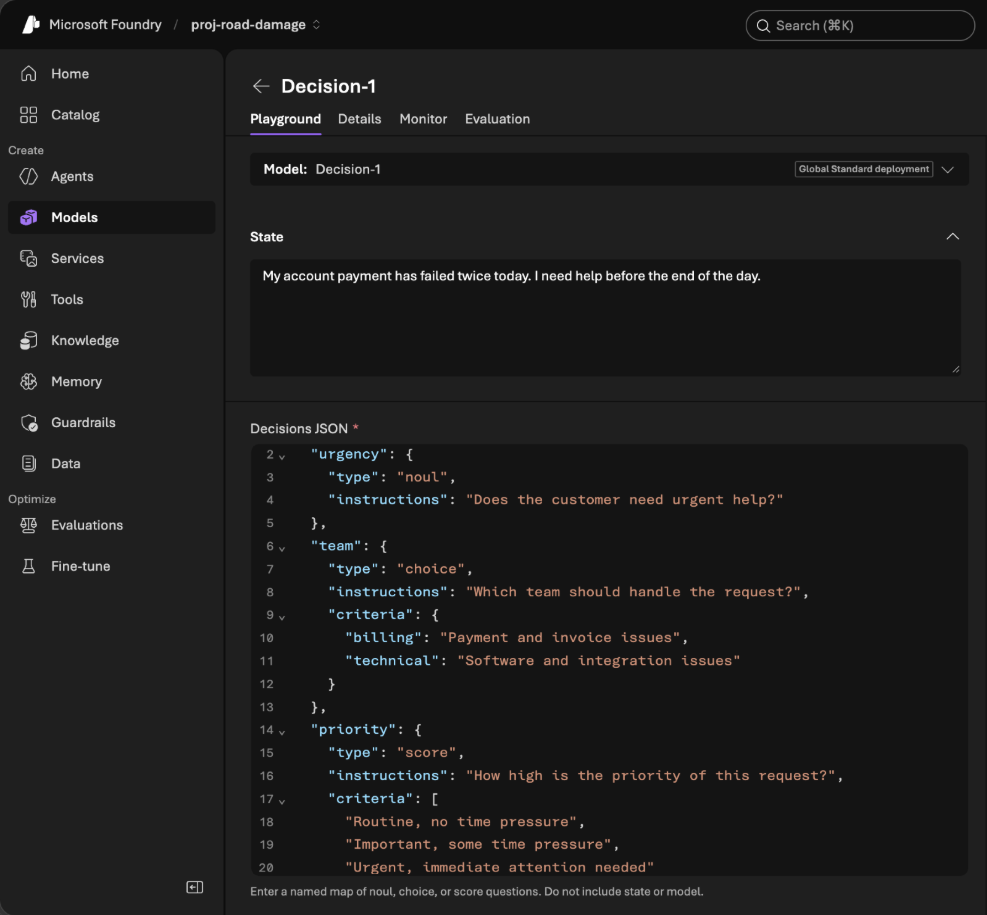
Stan wejściowy to wiadomość klienta:
My account payment has failed twice today. I need help before the end of the day.
Kontrakt definiuje trzy pytania. Pierwsze sprawdza, czy potrzebna jest pilna pomoc; drugie kieruje sprawę do zespołu rozliczeń albo technicznego; trzecie ocenia priorytet na trzech uporządkowanych poziomach.
{
  "model": "",
  "state": "My account payment has failed twice today. I need help before the end of the day.",
  "questions": {
    "urgency": {
      "type": "noul",
      "instructions": "Does the customer need urgent help?"
    },
    "team": {
      "type": "choice",
      "instructions": "Which team should handle the request?",
      "criteria": {
        "billing": "Payment and invoice issues",
        "technical": "Software and integration issues"
      }
    },
    "priority": {
      "type": "score",
      "instructions": "How high is the priority of this request?",
      "criteria": [
        "Routine, no time pressure",
        "Important, some time pressure",
        "Urgent, immediate attention needed"
      ]
    }
  }
}
model w wywołaniu jest nazwą wdrożenia w Foundry. Nie musi być identyczna z identyfikatorem modelu zwracanym w odpowiedzi. state może być tekstem lub JSON-em; w większym systemie warto przekazywać tylko informacje potrzebne do tej decyzji, np. treść, liczbę wcześniejszych kontaktów i istotne atrybuty transakcji. questions jest mapą, w której klucz staje się identyfikatorem wyniku. W definicji pytania type wybiera prymityw, instructions opisuje rozstrzygany problem, a criteria nadaje znaczenie kategoriom lub poziomom. Dla noul kryteria true/false są opcjonalne; w zadaniu o skutkach operacyjnych warto je dopisać, żeby rozgraniczyć np. „wymaga reakcji tego samego dnia” od „wymaga natychmiastowej interwencji”.
Odpowiedź i jej pola
W przedstawianym przykładzie API zwróciło następujące wyniki. Liczby zapisano z sześcioma miejscami po przecinku dla czytelności; oryginalna odpowiedź zawierała dłuższe wartości zmiennoprzecinkowe.{
"model": "microsoft-decision-1",
"answers": {
"urgency": {
"noul": 0.995930,
"type": "noul"
},
"team": {
"choice": "billing",
"confidence": 0.999408,
"probabilities": {
"billing": 0.999704,
"technical": 0.000296
},
"type": "choice"
},
"priority": {
"confidence": 0.696294,
"legend": {
"0": "Routine, no time pressure",
"1": "Important, some time pressure",
"2": "Urgent, immediate attention needed"
},
"probabilities": {
"0": 0.000824,
"1": 0.797529,
"2": 0.201647
},
"score": 1.200823,
"type": "score"
}
},
"usage": {
"input_tokens": 115,
"output_tokens": 3
}
} Na poziomie obiektu odpowiedzi model identyfikuje faktyczny model, który obsłużył request; może różnić się od nazwy deploymentu użytej w żądaniu. answers zawiera mapę decyzji pod kluczami z questions. Aplikacja powinna sprawdzać obecność każdego oczekiwanego klucza, jego type, typ wartości wyniku i to, czy etykieta choice należy do lokalnie dozwolonej listy. usage.input_tokens i usage.output_tokens są licznikami zwróconymi przez usługę. To metadane rozliczeniowo-operacyjne – temat mi niezwykle bliski i zapewne także przyszły temat wpisów na tym blogu.
Wartości noul i choice są proste do skonsumowania, ale nie powinny bezpośrednio sterować skutkiem ubocznym. Przykładowo urgency: 0.995930 można porównać z progiem wybranym po walidacji, a choice: billing można zmapować na kolejkę rozliczeń. Z kolei probabilities dla team pokazuje rozkład pomiędzy wariantami, co pozwala odróżnić wyraźny wybór od sytuacji niejednoznacznej.
Jak liczyć score
Dla poziomów o indeksach 0, 1 i 2 odpowiedź podaje odpowiednio około 0,000824, 0,797529 i 0,201647. Zwrócony wynik można odtworzyć jako wartość oczekiwaną indeksu:
score = 0 × P(0) + 1 × P(1) + 2 × P(2)
score ≈ 0 × 0,000824 + 1 × 0,797529 + 2 × 0,201647 = 1,200823
To wyjaśnia, dlaczego score nie jest etykietą z listy. Jest ciągłą średnią na osi poziomów, więc można go używać do sortowania lub progowania w ramach tej samej, stabilnie zdefiniowanej skali oceny. Jeśli poziomy mają nierówne odstępy semantyczne, indeksy 0, 1, 2 i tak traktują je jak równo odległe. Wtedy nie wolno interpretować wyniku jako skali interwałowej z naturalnym znaczeniem różnic; należy go traktować jako kolejność lub przybliżony ranking. Zmiana kolejności kryteriów zmienia znaczenie indeksów i może zmienić score. Dokumentacja rekomenduje używać score do porządku względnego oraz progów zwalidowanych na własnych przykładach, a nie jako bezwzględnego, skalibrowanego ratingu.
Co można powiedzieć o confidence
Dla choice API zwraca zarówno wybraną etykietę, rozkład probabilities, jak i confidence; dla score także zwraca confidence, rozkład po poziomach i score. Microsoft opisuje model jako zwracający skalibrowane prawdopodobieństwa opcji oraz mówi o sygnałach pewności. W publicznej dokumentacji endpointu nie znalazłem definicji matematycznej pola confidence, która pozwalałaby przypisać mu konkretny wzór. Nie należy więc twierdzić, że jest to maksimum rozkładu, margines dwóch najlepszych opcji, entropia albo prawdopodobieństwo trafności. W przykładzie team.confidence (0,999408) nie jest równe P(billing) (0,999704), co samo w sobie pokazuje, że tych pól nie można utożsamiać.
Praktycznie: zapisuj oba pola osobno, sprawdź ich zachowanie na oznaczonych danych i zbuduj własną krzywą jakości dla konkretnego zadania. Jeżeli reguła biznesowa potrzebuje skalibrowanego prawdopodobieństwa klasy, użyj probabilities i zweryfikuj kalibrację. confidence traktuj jako dodatkowy sygnał dostarczany przez usługę, dopóki dokumentacja wersji API nie określi jego semantyki bardziej precyzyjnie.
Zauważalna jest różnica pomiędzy urgency (około 0,996) a priorytetem, gdzie poziom 1 ma prawdopodobieństwo około 0,798. Nie musi to być sprzeczność: pytanie binarne mówi o potrzebie pilnej pomocy, natomiast górny poziom skali wymaga natychmiastowej uwagi. Jeżeli organizacja definiuje pilność jako SLA „do końca dnia”, a najwyższy priorytet jako „natychmiast”, te wyniki mogą być spójne. Model nie zna jednak lokalnej polityki, jeśli nie została wyrażona w stanie lub kryteriach.
Tokeny i rachunek kosztu
Przykładowa odpowiedź raportuje input_tokens = 115 i output_tokens = 3. To użyteczny fakt dla tego requestu, ale nie obietnica, że każdy wariant pytania, dłuższa wiadomość czy inna wersja usługi będzie kosztować tyle samo. Token wejściowy obejmuje reprezentację wejścia liczoną przez usługę, a więc w praktyce rośnie wraz z treścią state, pytaniami, instrukcjami i kryteriami. Warto mierzyć rzeczywiste rozkłady wejściowych tokenów na własnym ruchu. Krótkie output_tokens nie oznaczają, że treść JSON-u zajmuje trzy tokeny: JSON z polami, prawdopodobieństwami i metadanymi jest dużo dłuższy w bajtach. Token usage odzwierciedla rozliczeniową konwencję usługi, a nie transport HTTP.
Koszt tokenowy nie jest samym kosztem całego rozwiązania. Do TCO należą wywołania, ewentualna minimalna stawka lub rezerwacja przepustowości, warstwa gateway, logowanie, retries, walidacja, przechowywanie danych, przegląd człowieka i skutki błędnych decyzji. Łączenie trzech powiązanych pytań w jeden request może ograniczyć liczbę wywołań; nie należy natomiast zakładać, że dodanie pytań nic nie kosztuje — prompt rośnie, a dokładny sposób naliczania trzeba odczytać z usage i cennika dla wdrożenia.
Porównanie scenariuszy
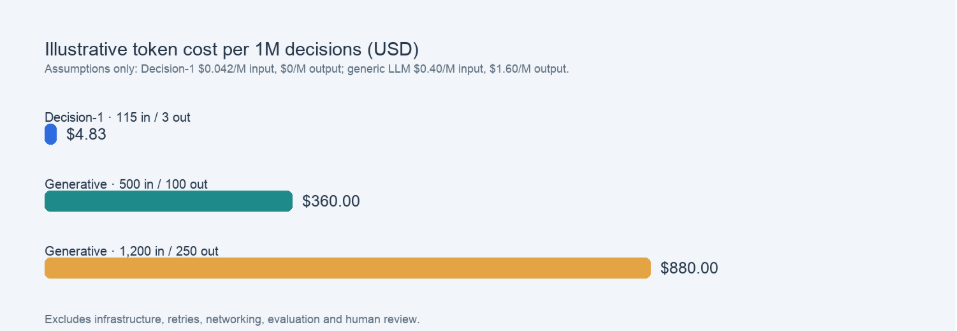
Poniższa kalkulacja jest ilustracyjna i nie jest konkretną wyceną z prostego powodu: na dzień pisania tego tekstu katalog modeli oznacza Decision-1 jako Preview. Publicznie dostępna strona cenowa podaje koszt 0,042 USD za milion tokenów wejściowych i darmowe tokeny wyjściowe; Czy takie ceny będą identyczne, gdy model wyjdzie z Preview? Tego nie wiem. Parametry standardowego generatywnego LLM również są założeniem porównawczym, a nie konkretną ofertą dostawcy: 0,40 USD/M tokenów wejściowych oraz 1,60 USD/M tokenów wyjściowych.
Wzór na koszt na milion zdarzeń to N × (Tin × Pin + Tout × Pout) / 1 000 000, gdzie N to liczba requestów, Tin i Tout średnie tokeny na request, a Pin i Pout ceny za milion tokenów.
| Scenariusz na request | Tokeny wejściowe | Tokeny wyjściowe | D1 przy założeniu 0,042/0 USD za M | LLM przy założeniu 0,40/1,60 USD za M |
|---|---|---|---|---|
| Przykład z rozmowy, D1 | 115 | 3 | USD 0.00000483 | ___ |
| Generatywny JSON, krótki | 500 | 100 | ___ | USD 0.000360 |
| Generatywny JSON, rozbudowany | 1,200 | 250 | ___ | USD 0.000880 |
Przy milionie decyzji pierwsza konfiguracja D1 kosztowałaby w tym scenariuszu 4,83 USD. Generatywny wariant krótki kosztowałby 360 USD, a rozbudowany 880 USD. Przy 10 milionach odpowiednio 48,30 USD, 3 600 USD i 8 800 USD; przy 100 milionach 483 USD, 36 000 USD i 88 000 USD. Wariant krótki to około 74,5 raza większy koszt tokenowy niż przyjęty D1; wariant rozbudowany około 182 razy. Różnica wynika głównie z przyjętej stawki oraz liczby tokenów, a nie z uniwersalnej przewagi cenowej modelu Decision.
Ta tabela nie porównuje jakości, opóźnienia ani całego kosztu systemu. LLM-owi można przekazać dodatkowe zadanie wyjaśnienia, podsumowania lub ekstrakcji; Decision-1 takich rezultatów nie dostarczy. Z drugiej strony wymuszanie przez LLM wygenerowanego JSON-u, walidowanie go i ponawianie nieudanego wywołania może powiększyć koszt poza prostym przykładem. Uczciwe porównanie powinno użyć tego samego zestawu zdarzeń, tej samej informacji wejściowej, jakości wymaganej przez biznes i aktualnych cen – wszystko w kontekście Waszych środowisk, a nie mojego demo.
Wzorzec architektoniczny
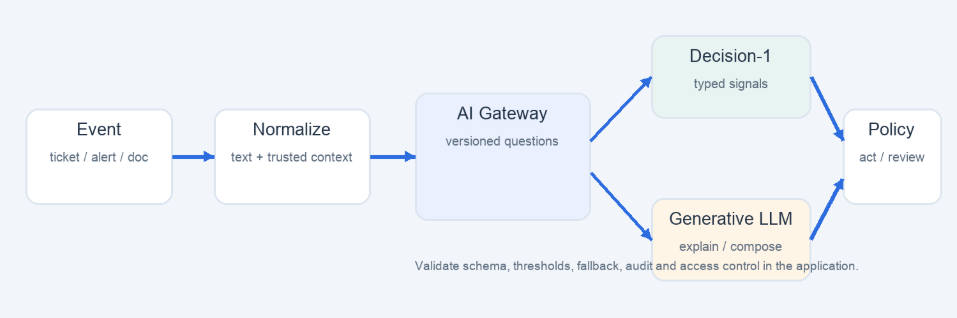
Decision-1 najłatwiej umieścić jako wąski komponent pomiędzy normalizacją zdarzenia a wykonaniem działania. Aplikacja lub AI gateway tworzy state, dołącza wersjonowany kontrakt pytań i wysyła request. Po stronie integracji walidator sprawdza kształt JSON-u, wymagane klucze, zakresy, listy dozwolonych wartości i kompletność rozkładów. Polityka decyzyjna dopiero wtedy wybiera automatyczne działanie, fallback lub kolejkę do człowieka. Ten podział zachowuje reguły wykonawcze w systemie, a model dostarcza sygnał do nich.
Routing i klasyfikacja dokumentów. choice pasuje do zamkniętego katalogu zespołów, typów dokumentu, kolejek lub modeli. Dla dokumentu wejście powinno być wynikiem OCR/parsowania, a nie samym plikiem, ponieważ model jest tekstowy. Długie dokumenty trzeba dzielić lub streszczać innym komponentem; ten dodatkowy etap ma własne ryzyko utraty kontekstu oraz koszt. Katalog wskazuje limit do 32K tokenów, ale limit nie znaczy, że pełny dokument zawsze warto przesłać.
Zdarzenia i alerty. noul może odsiać warunki wejścia do procesu, a score uporządkować kolejkę incydentów lub zgłoszeń. Wynik dobrze nadaje się do priorytetyzacji, jeżeli poziomy są spójne i zespoły rozumieją, jak indeksy mapują się na SLA. Dla alertów krytycznych bezpieczniej potraktować model jako dodatkowy sygnał niż jedyny mechanizm tłumiący.
Orkiestracja agentów. Przed wykonaniem narzędzia system może ocenić, czy proponowana akcja jest dozwolona, czy wymaga zgody albo który agent powinien ją obsłużyć. Microsoft wymienia ocenę działań agenta i wybór narzędzia/modelu jako zastosowania. To jednak nie jest autoryzacja. Decyzja nie może zastąpić kontroli uprawnień, walidacji argumentów narzędzia, limitów transakcyjnych ani deterministycznych reguł polityki.
AI gateway i kaskada modeli. Gateway może kierować prosty, strukturalny przypadek do Decision-1, a dopiero sprawy poza zakresem do generatywnego LLM. Taki routing może obniżyć średni koszt w mieszanym ruchu. Korzyść jest hipotezą architektoniczną, którą trzeba zmierzyć: dochodzi kolejny request, a błędna klasyfikacja wstępna może pogorszyć jakość całej kaskady. Warto logować wersję zestawów kryteriów, token usage, rozkład klas, opóźnienia, fallbacki i błąd względem etykiet referencyjnych.
Scoring i guardrails. Można oceniać odpowiedzi modelu pod kątem zgodności z rubryką lub sprawdzać ryzykowne warunki. Wynik nie jest dowodem prawdziwości ani formalną gwarancją bezpieczeństwa. Microsoft wskazuje ryzyko błędów klasyfikacji treści szkodliwych i wrażliwość na sformułowanie pytań/opcji. Dlatego próg powinien być dobrany do kosztu false positive i false negative, a przypadki graniczne kierowane do kolejnego sprawdzenia albo człowieka.
Wydajność, niezawodność i granice bezpieczeństwa
Microsoft opisuje single-pass decision scoring i do 32K tokenów kontekstu. Nie należy jednak utożsamiać jednego przejścia modelu z określonym SLA. Rzeczowa przewaga nad generatywnym interfejsem polega na odpowiedzi o przewidywalnym kształcie. Wciąż należy obsłużyć błąd transportu, brak pola, nieznany typ, niepoprawną etykietę, timeout, powtórzone żądanie i wersję deploymentu. Warto mieć kontraktowe testy dla schematu wejścia/wyjścia oraz retry idempotentne po stronie aplikacji. Automatyczna akcja powinna wymagać także reguł domenowych, np. weryfikacji statusu płatności w systemie źródłowym, zamiast traktowania treści klienta jako faktu.
W granicach bezpieczeństwa wejście jest nadal nieufnym tekstem. Prompt injection w treści zgłoszenia nie znika dlatego, że model nie generuje odpowiedzi. Jeśli Decision-1 ocenia ryzyko, to jego wynik jest jednym z sygnałów i może zostać ominięty. Nie przekazujcie mu sekretów, których klasyfikacja nie wymaga; stosujcie minimalizację danych, kontrolę dostępu do logów, retencję zgodną z polityką oraz ochronę przed masowym nadużyciem endpointu. Przy decyzjach o skutkach dla ludzi model nie powinien być jedynym decydentem (mam nadzieję, że to dla Was oczywiste). Microsoft zaleca walidację reprezentatywnych danych, progi oparte na konsekwencjach błędu, możliwość abstencji typu „cannot tell”, monitoring nierówności i znaczący nadzór człowieka w zastosowaniach wysokiego ryzyka – ja też to zalecam.
Najważniejsze ograniczenie operacyjne wynika z samej konstrukcji pytania: zamknięty zbiór odpowiedzi wymusza wybór. Jeśli możliwy przypadek nie mieści się w żadnej kategorii, trzeba dodać opcję „other” lub „cannot tell” i sprawdzić, czy model potrafi jej używać. Bez tego wysoka pewność może maskować błąd ontologii, nie tylko błąd modelu. Wersjonujcie instructions i criteria jak kod: zmianę opisów, kolejności poziomów, progów oraz mapowania na kolejki poddawaj regresji na zbiorze referencyjnym.
Wniosek dla architekta
Decision-1 jest sensownym kandydatem na etap podejmujący małe, zamknięte decyzje w przepływie, którego kolejne kroki są już opisane przez aplikację. Warto rozważyć go w routingu, triażu, klasyfikacji, rankingu i wyborze następnego komponentu, szczególnie przy dużej liczbie zdarzeń i małym wymaganym wyniku. Nie zastąpi generatywnego modelu tam, gdzie produktem ma być tekst, ani silnika reguł tam, gdzie wymagana jest deterministyczna zgodność z polityką.
Przed wdrożeniem trzeba odpowiedzieć na cztery pytania: czy rubryka obejmuje realne przypadki; jaka jest jakość przy progach i opcjach abstencji; jaki jest koszt po podstawieniu aktualnego cennika i rzeczywistego rozkładu tokenów; oraz co robi system przy niepewności, błędzie API lub zmianie wersji. Dopiero wtedy krótki wynik i niski koszt tokenowy stają się argumentem architektonicznym, a nie tylko atrakcyjną liczbą z pojedynczej próbki.